


Que no se quemen los tokens: lo que nadie te dice sobre el coste real de usar IA en tu práctica…y cómo no arruinarte en el intento
 Karol Valencia
La abogada Karol Valencia es Founder de WOW Legal Experience y Legal Process Engineer y adoption manager en Saga, además de consultora, docente y speaker. Karol aborda en este artículo un tema trascendental como es la economía del token, y lo hace proporcionando claves para no cargarte tu presupuesto en IA antes de lo que te piensas.

Un token. Así se llama la unidad mínima que procesa un modelo de lenguaje. Aproximadamente cuatro caracteres de texto en inglés —un poco menos en español por la mayor longitud de nuestras palabras. Invisibles, silenciosos, acumulándose en segundo plano mientras tú redactas, consultas y pides análisis a tu herramienta de IA.
Lo que nadie te explica al suscribirte a Harvey, a CoCounsel, a Westlaw AI o a cualquier plataforma de IA jurídica es que el coste real de usarla no depende solo del precio de la licencia. Depende de cuántos tokens consumes. Y eso, en el contexto de la práctica jurídica —con sus documentos largos, sus conversaciones multiturno y sus flujos de trabajo cada vez más agénticos— puede convertirse en una factura inesperadamente alta.
Este artículo no es una alarma. Es una guía para entender qué estás pagando realmente, cómo controlarlo, y por qué la próxima gran competencia estratégica en los despachos no será sobre qué herramienta de IA tienes, sino sobre qué tan eficientemente la usas.
Qué es un token y por qué debería importarme
Antes de hablar de dinero, hay que entender la mecánica. Un token no es una palabra, ni un carácter, ni una línea. Es un fragmento de texto que el modelo procesa como unidad mínima. Una frase como «El contrato de arrendamiento» equivale a aproximadamente seis tokens. Un contrato tipo de cinco páginas equivale a unos 6.000 tokens. Un expediente completo de 50 páginas puede suponer entre 60.000 y 80.000 tokens.
Los proveedores cobran por millón de tokens procesados, distinguiendo entre tokens de entrada —lo que tú envías al modelo— y tokens de salida —lo que el modelo te devuelve—. Y aquí está el primer dato que sorprende a la mayoría: los tokens de salida cuestan entre tres y seis veces más que los de entrada.
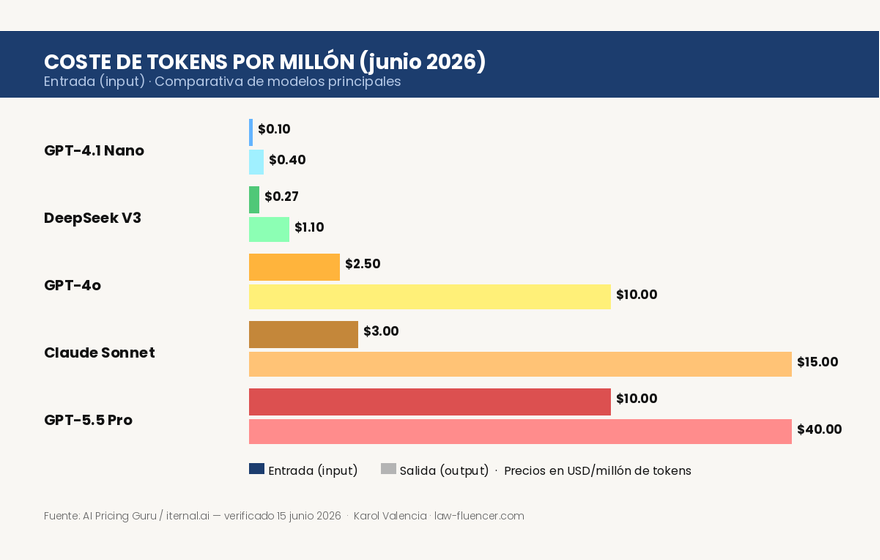
Precios reales de los modelos principales (junio 2026)
- GPT-4.1 Nano (OpenAI): $0,10 entrada · $0,40 salida por millón de tokens
- DeepSeek V3: $0,27 entrada · $1,10 salida ← mejor relación precio/capacidad
- GPT-4o (OpenAI): $2,50 entrada · $10,00 salida
- Claude Sonnet 4.6 (Anthropic): $3,00 entrada · $15,00 salida
- GPT-5.5 Pro: $10,00 entrada · $40,00+ salida
- Los precios de LLMs cayeron un 80% entre principios de 2025 y principios de 2026.
Fuente: AI Pricing Guru / iternal.ai — verificado a 15 de junio de 2026.
Un análisis de un contrato de cinco páginas con Claude Sonnet cuesta aproximadamente $0,03 de tokens. Parece irrelevante. Y lo es, si lo haces una vez. El problema aparece cuando escalas: 200 contratos al mes, flujos agénticos multipasos, conversaciones largas con historial acumulado.
El problema oculto: el coste cuadrático de las conversaciones largas
Aquí está la trampa que más sorprende a los abogados que empiezan a usar IA de forma intensiva. En una conversación con un modelo de lenguaje, cada nuevo mensaje que envías no solo procesa ese mensaje: procesa todo el historial de la conversación desde el inicio. El modelo necesita «ver» todo el contexto previo para darte una respuesta coherente.
La consecuencia matemática es brutal: el coste por mensaje crece de forma cuadrática, no lineal. Un estudio publicado por Intuition Labs (2026) lo documentó con precisión: en una sesión de trabajo real con Claude, una pregunta de 14 tokens al inicio de la conversación costó $0,0018. La misma pregunta de 14 tokens en el intercambio número 260 de esa misma sesión costó $2,41. Un incremento de 1.339 veces, sin que la pregunta cambiara en absoluto.
El token no es el coste. El historial acumulado es el coste. Y la mayoría de los abogados no lo está midiendo.
Esto tiene implicaciones directas para la práctica jurídica: una sesión de trabajo intenso con una herramienta de IA durante un día entero puede consumir fácilmente 500.000 tokens o más si no se gestiona activamente el contexto. A precios de Claude Sonnet, eso supone $7,50–$9 en una sola sesión. Para un equipo de diez abogados trabajando así a diario, el coste mensual solo en tokens puede superar los $2.000, antes de contar la licencia de la plataforma.
El truco del formato: markdown como palanca de ahorro
Hay un tip que casi nadie menciona en los webinars de IA para abogados, y que sin embargo tiene uno de los impactos más inmediatos sobre el consumo de tokens: el formato en que preparas tus documentos antes de pasarlos al modelo.
Cuando subes un documento en HTML puro —el formato nativo de muchas webs jurídicas, boletines oficiales o plataformas de gestión documental— estás pagando tokens por etiquetas, estilos CSS, scripts y metadatos que el modelo no necesita para entender el contenido jurídico. Es ruido caro.
La alternativa es Markdown: un formato de texto plano con estructura semántica mínima (encabezados con #, negritas con **, listas con -) que los modelos de lenguaje procesan de forma nativa porque fueron entrenados con enormes cantidades de texto en ese formato —GitHub, documentación técnica, foros especializados.
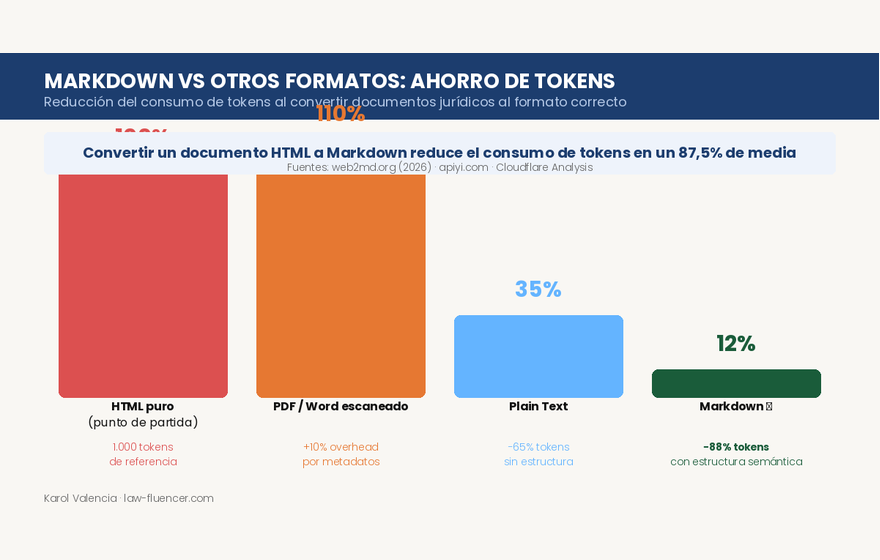
El impacto del formato en el consumo de tokens
- HTML puro → 100% tokens de referencia (punto de partida).
- PDF o Word escaneado → ~110% (overhead de metadatos).
- Texto plano → ~35% de los tokens del HTML. Ahorra mucho, pero pierde estructura semántica.
- Markdown ✓ → ~12% de los tokens del HTML. Ahorra ~87,5% conservando jerarquía y estructura.
- Convertir un documento HTML a Markdown puede ahorrar entre el 80% y el 94% de tokens de entrada.
Fuentes: web2md.org (2026) · apiyi.com · Cloudflare Analysis.
Para el abogado práctico, esto tiene una implicación concreta: si trabajas habitualmente con documentos extraídos de webs del BOE, de bases de datos jurídicas que exportan HTML, o de contratos en formato Word que luego pegas directamente al chat, estás dejando entre un 67% y un 87% de ahorro en tokens sobre la mesa. Herramientas como web2md.org permiten convertir cualquier URL a Markdown limpio en segundos.
Markdown no es solo un formato de texto. Es, en 2026, el idioma nativo de los modelos de lenguaje — y la forma más barata de hablarles.
En próximos artículos compartiré más tips prácticos de este tipo: prompts que ahorran tokens, cuándo usar modelos ligeros en lugar de frontier, y cómo configurar el caché de contexto para reducir costes hasta un 90% en flujos de trabajo repetitivos. Si te interesa, sígueme para no perderte la siguiente entrega.
Lo que les espera a los grandes despachos… y la lección para todos
Artificial Lawyer publicó el 4 de junio de 2026 un análisis revelador sobre los costes futuros de IA para las grandes firmas. La conclusión principal: hoy, la mayoría de los abogados del mundo no usa IA de forma intensa —y eso mantiene los costes artificialmente bajos. El problema llegará cuando la adopción se generalice.
Richard Tromans lo formuló con una metáfora perfecta: ahora mismo, la mayoría de los despachos son conductores noveles que consumen poco combustible. En dos o tres años, cuando sean conductores experimentados haciendo viajes largos, el consumo se multiplicará exponencialmente.
Estimación de costes de IA para grandes firmas (2026 vs 2029)
- Una firma de 3.000 abogados con 50% de usuarios activos diarios: estimación $1M–$3M anuales en tokens + licencias en 2026.
- La misma firma en 2029 con uso agéntico generalizado: los costes se multiplican significativamente.
- ‘Tokens cannot be destroyed, only who pays for them changes’ — Artificial Lawyer parafraseando a Newton.
Fuente: Artificial Lawyer, Token Costs and the Future of Law Firm AI Spend, 4 de junio de 2026.
Las cinco palancas para controlar el coste de los tokens
- Elección de modelo según tarea
No todas las tareas jurídicas requieren el modelo más potente. Resumir un acta de reunión no necesita GPT-4o ni Claude Sonnet: un modelo ligero como GPT-4.1 Nano ($0,10/$0,40 por millón de tokens) es 25 veces más barato y perfectamente capaz para esa tarea.
- Gestión activa del contexto
La estrategia más efectiva para evitar el coste cuadrático: abrir nuevas conversaciones frecuentemente en lugar de acumular historial indefinidamente. Una conversación de 50 intercambios puede costar más del doble que cincuenta conversaciones de un intercambio cada una, para el mismo volumen total de información procesada.
- Markdown como formato estándar de trabajo
Como hemos visto, convertir documentos a Markdown antes de pasarlos al modelo puede reducir el consumo de tokens de entrada hasta un 87,5%. Es la palanca de mayor impacto inmediato y menor coste de implementación.
- Caché de contexto
Los principales proveedores —OpenAI, Anthropic, Google— ofrecen descuentos de entre el 50% y el 90% sobre tokens de entrada cacheados. Para flujos de trabajo que usan los mismos documentos base repetidamente —plantillas de contratos, políticas internas, legislación de referencia— activar el caché puede reducir los costes de entrada a la décima parte.
- Enrutamiento inteligente entre modelos
Las plataformas legaltech especializadas ya implementan enrutamiento automático: asignan cada consulta al modelo más económico capaz de resolverla. Este es uno de los argumentos más sólidos a favor de las plataformas especializadas frente al uso directo de la API de un solo proveedor.
La conclusión estratégica
La tokenomía , o la economía de los tokens, va a convertirse en una competencia estratégica en los despachos en los próximos dos años. Los CFOs y responsables de Legal Ops que hoy no están midiendo el consumo de tokens de sus equipos están acumulando una deuda de visibilidad que les pasará factura cuando la adopción se generalice y los costes escalen.
Saber cuántos tokens consume tu práctica jurídica no es una cuestión técnica. Es una cuestión de gestión empresarial. Y cuanto antes empieces a medirlo, mejor posicionado estarás cuando el resto del sector empiece a preguntarlo.
Referencias
→ Artificial Lawyer (4 junio 2026) — Token Costs and the Future of Law Firm AI Spend. https://www.artificiallawyer.com/2026/06/04/token-costs-and-the-future-of-law-firm-ai-spend/
→ IntuitionLabs (2026) — Token Optimization and Cost Management — crecimiento cuadrático del coste (1.339x en sesiones largas). https://intuitionlabs.ai/articles/token-optimization-chatgpt-claude-costs
→ AI Pricing Guru (junio 2026) — AI API Pricing 2026 — 112 modelos, actualización diaria. https://www.aipricing.guru/calculators/token-cost/
→ iternal.ai (2026) — AI API Pricing Calculator 2026 — caída del 80% en precios 2025–2026. https://iternal.ai/llm-pricing-calculator
→ web2md.org (2026) — HTML vs Markdown for LLMs — ahorro de 87,5% de media en tokens de entrada. https://web2md.org/blog/markdown-vs-html-for-llm
→ apiyi.com (2026) — Token saving with Markdown corpus — conversión HTML→Markdown ahorra 70–80%. https://help.apiyi.com/en/llm-markdown-corpus-token-saving-4-methods-comparison-en.html
→ iternal.ai (2026) — Tokenization Guide 2026 — formatos estructurados reducen consumo ~67% vs HTML. https://iternal.ai/token-usage-guide
→ Ramp (2026) — How Much Do AI Tokens Cost Businesses? — diferencial 20x entre modelos. https://ramp.com/blog/ai-token-cost-for-businesses