


#UsosLegaltech: Extracción automatizada de datos de documentos para volcado en sistemas o bases de datos y posterior reutilización
 Rocío Ramírez

Descripción del caso de uso:
Es habitual que los abogados debamos extraer información y datos de documentos para la codificación o volcado en nuestros sistemas o base de datos, o para su transcripción en los escritos o documentos legales que estemos elaborando, o para autocompletar las plantillas o modelos de escritos legales que estemos articulando.
La dinámica habitual para extraer y reutilizar esta información es el “copia-pega”, es decir, seleccionamos los datos que precisemos en el documento y clicamos en la opción de copiar, para luego seleccionar el espacio donde necesitamos introducirlos, y clicamos pegar.
Describiendo más gráficamente el proceso, si nuestro cliente es una entidad financiera que recurrentemente nos provee de asuntos judiciales en los que ha sido emplazada como demandada, deberemos codificar en nuestros sistemas la información y datos que precisemos extraer de la cédula de emplazamiento y del escrito de demanda que nos haga llegar, como son juzgado, autos, demandante así como su abogado y procurador, vencimiento, tipo de acción, cuantía del procedimiento, petición del suplico, fecha y datos del contrato en lo que se base la petición, etc. O si nuestro cliente es una compañía de suministro, que nos provee del contrato y reclamación amistosa de las cantidades adeudadas por su cliente, para interponer la correspondiente demanda de reclamación de cantidad o petición de juicio monitorio, igualmente deberemos extraer nombre y datos de su cliente, fecha y datos del contrato, objeto de la prestación de servicio, precio, duración, importe adeudado, etc. O si debemos articular contratos de compraventa de inmuebles o de arrendamiento, deberemos extraer la información y descripción de las fincas objeto de contrato de las notas simples, para ser volcadas en los documentos que estemos confeccionando, por referir sólo algunos ejemplos.
Esta información es esencial para identificar y tramitar correctamente nuestros asuntos, y es la que recurrentemente utilizaremos con cualquier documento que elaboremos o trámite que completemos. Pero habitualmente es extraída con esta dinámica del copia pega, que utilizada de forma recurrente en múltiples trámites y gestiones propias de nuestro día a día, se termina convirtiendo en una importante carga de trabajo, de carácter repetitivo y rutinario, ya que se reutiliza para completar contratos o acuerdos, demandas, contestaciones y recursos, peticiones o solicitudes, minutas, facturas, plantillas de correos electrónicos, o cualquier otro tipo de documento que debamos confeccionar.
Problema que tratamos resolver:
La acción “copia-pega” en sí no requiere de mucho tiempo, pero si a lo largo de la jornada debemos replicar esta acción de forma constante, estaremos dedicando tiempo y recursos a una partida de trabajo que puede ser fácilmente automatizable.
Es habitual que este grado de esfuerzo sea directamente proporcional al volumen de asuntos que gestionemos en los que de forma recurrente debamos extraer información y datos de documentos. Por eso, cuanto mayor sea el nivel de esfuerzo en dicho sentido, más necesario será implementar sistemas que nos ayuden a ser cuanto más eficientes podamos en la gestión de esta partida, y que se constituye como una de las de las tareas de escaso valor más común en cualquier despacho o asesoría jurídica. Mejorando eficiencias en este sentido, disminuiremos el coste de tramitación de cada asunto, y mayor será el margen de beneficio que nos deje cada uno de los expedientes tramitados.
Para ilustrar el caso de uso y retomando el ejemplo de dar de alta un expediente, para completar la tarea bastará con trascribir o seleccionar, copiar y pegar la información y datos necesarios para proceder en dicho sentido. De forma aislada no es un ejercicio que consuma mucho tiempo. Pero si la acción no solo la debo hacer para crear ficha del asunto, si no también para elaborar la hoja de encargo, para redactar el cuerpo del email por la que se la hago llegar al cliente, para articular el escrito de demanda, contestación o contrato que nos haya encargado, para completar los distintos escritos de trámite o documentos que sean necesarios o para elaborar la minuta o factura, y así con el grueso de asuntos que engrosa nuestra cartera, resultará que esta simple y sencilla acción, habrá absorbido una considerable parte de nuestro tiempo. Tiempo que habremos dejado de destinar a cuestiones de mayor calado.
Se trata, además, de una tarea muy repetitiva, ya que normalmente solemos extraer la información de forma recurrente de los mismos documentos, que se replican constantemente con idéntico patrón, formato y estructura, para luego ser volcados o transcritos en otros documentos, muchos de ellos de carácter también habitual.
Ejemplos son la ya referida cédula de emplazamiento, una nota simple, un contrato (ya sea de trabajo, de suministro, de prestación de servicio, de arrendamiento, de financiación, etc.), una resolución administrativa, una nómina, un extracto de movimientos bancarios, o cualquier otro documento sobre el que habitualmente trabajemos.
Es de mencionar también, que esta extracción manual es además muy propensa a errores humanos, ya que es muy fácil “bailar” un número o carácter en la trascripción.
Cómo la tecnología puede mejorar eficiencias y agilizar dicha tarea:
Nuevamente la tecnología resulta de gran ayuda para automatizar la tarea, ya que puede procesar grandes cantidades de información y datos en un corto período de tiempo, lo que la hace mucho más eficiente que los métodos tradicionales.
Existen en el mercado multitud de soluciones en este sentido. Las funcionalidades principales que nos ayudarán en esta tarea será la OCR y la IA.
Los sistemas de OCR (Optical Character Recognition), reconocen y extraen los caracteres consignados en una concreta ubicación, para su posterior tratamiento. Esta funcionalidad nos permitirá automatizar la extracción de datos cuando respeten un patrón, estando siempre consignados en la misma zona del documento. Y la extracción la efectúa sin realizar ejercicio cognitivo alguno, y se limita a extraer el dato o la información para ser volcada donde le indiquemos.
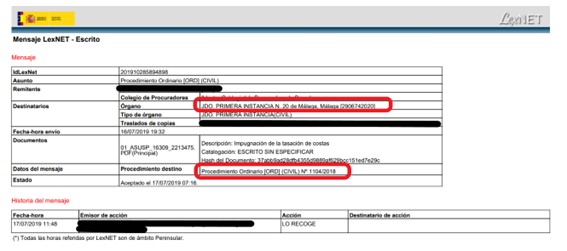
Un ejemplo podría ser la cédula de Lexnet de una notificación, donde el juzgado y número de autos aparece consignado siempre en el mismo recuadro y ubicación del documento. El sistema no “entiende” si lo que nos está devolviendo es el juzgado o el número de autos, simplemente se limita a extraer los datos consignados en la zona que le hemos indicado. Por eso es esencial que el mismo tipo de información, esté ubicada siempre en el mismo lugar, ya que, si por ejemplo se cambiara de ubicación, el sistema seguiría extrayendo la información reflejada, independientemente de que ya no fueran el juzgado o el número de autos, puesto que no tiene capacidad de buscar en el documento la información precisada y analizar si lo que ha encontrado pudiera ser o no lo que requerimos.
Incluyo print que a continuación, en el que marco en color rojo, la información y datos que mantienen la estructura similar.
Pero no solo es aplicable a la cédulas de Lexnet, si no a facturas, recibos, contratos, extractos, justificantes o cualquier otro tipo de documento que contenga información de forma estructurada. Básicamente debe tratarse de una plantilla normalizada utilizada siempre para consignar la misma información.
Pero si el dato, a pesar de estar localizado en la misma área del documento, varía mínimamente en su ubicación y no respeta el patrón ni se consigna siempre en el mismo lugar, hace falta IA para poder ser extraída.
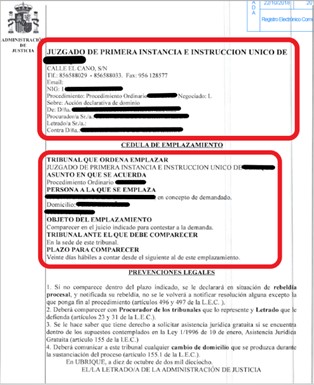
Un claro ejemplo es una notificación del juzgado, donde habitualmente se consigna siempre la misma información y datos del asunto, como juzgado, dirección y teléfono, número de autos, NIG, demandante, demandado y sus abogados y procuradores, etc. Pero no siempre se respeta el mismo exacto orden y ubicación de la información, y cada uno la organiza de un modo diferenciado, ya que cada juzgado tiene su propia plantilla de documento, y algunos la consignan más arriba, otros más abajo, algunos eliminan campos si no hay información que facilitar, como pueda ser el datos del procurador si no es preceptivo, y en cambio otros dejan dicho campo en blanco.
Estas mínimas variaciones requieren que un sistema “más inteligente” determine si la información que está leyendo corresponde al NIG o al número de autos, o si el campo que me devuelve para el letrado, es el del demandante o el del demandado. Es necesario que el sistema haga un ejercicio “cognitivo” para que nos pueda devolver la información requerida.
A continuación incluyo print de una notificación del juzgado, en el que recuadro en color rojo la información que siempre aparece, pero no siempre manteniendo la misma forma, estructura y ubicación.
Ya sea a través de OCR o de IA, si indicamos a nuestros sistemas qué información y datos debemos extraer con carácter recurrente, y en qué formato la necesitamos, éstos replicarán la acción en escasos segundos, y una vez procesados los documentos, los sistemas nos la devolverán en el formato deseado (ya sea en formato Excel, a través de json, o por medio de una API), y nos proveerán de la que precisemos, para ser volcada en nuestros aplicativos, software de gestión, CRM, ERP, base de datos o sistema que empleemos para gestionar nuestros asuntos, para su importación y codificación a golpe de un solo clic.
Y volcada y codificada la información, podremos darle el uso que precisemos, como dar de alta el expediente si no lo tuviéramos creado, podríamos completar el juzgado y número de autos si el expediente ya estuviera creado pero esta información estaba pendiente de codificarse a la espera de que se nos notificara la primera resolución del asunto, podrá ser reutilizada para autocompletar futuros escritos de trámite, recursos, para incluirlos en minutas o facturas, en recibís, para plantillas de correos, reclamaciones o en otros usos que necesitemos.
Automatizando esta partida de trabajo mejorará la calidad de nuestros servicios, porque además de minimizarse el error humano, podremos focalizarnos en las tareas y actividades de mayor calado jurídico, aportando mayor valor agregado a nuestros clientes. Porque ningún abogado estudió Derecho para “picar” datos. Y ello sin mencionar la reducción de costes y optimización de recursos internos que nos procurará.
Funcionalidades involucradas:
La extracción de información y datos pude hacerse a través de sistemas OCR (Optical Character Recognition) para información completamente estructurada y que cuente con el mismo patrón; o a través de sistemas de IA (Inteligencia Artificial), cuando la información y datos no respeten dicha estructura y patrón.
Afortunadamente en el mercado hay cada vez más herramientas y soluciones que integran estas funcionalidades, estando diseñadas, definidas y parametrizadas para extraer información de los más diversos tipos de documentos legales, como puedan ser notificaciones judiciales, contratos, extractos, recibos y facturas, notas simples, etc.
Y nuevamente se hace esencial contar con un software de gestión, aplicativo o sistema que posibilite codificar de forma estructurada y organizada toda la información devuelta por los sistemas. Como ya he dejado indicado otras veces, es esencial que confirmemos si permite la importación de datos, y en caso positivo, verificar con carácter previo con qué requisitos, para asegurarnos que el sistema de IA o OCR empleado, y el nuestro “hablen el mismo idioma”, y puedan intercambiar de forma efectiva toda esta información, ya que no todos los softwares de gestión del mercado posibilitan este intercambio. Es imprescindible también confirmar que nuestro software cuente con todos los campos necesarios para poder registrar toda la información que precisemos, ya que, en caso contrario, la información devuelta no tendrá donde codificarse y se perdería.
Es de referir, además, que algunos softwares de gestión integran funciones de extracción con OCR de información y datos.
Enlaces recomendados:
Guía Legaltech: Análisis, revisión y generación de documentos. Automatización documental y de procesos. Softwares de gestión de despachos y asesorías.
“Legal Tech aplicado a la gestión de Litigios en despachos de abogados”, editorial LA LEY, Madrid, mayo 2022, páginas 342 y ss. y 364 y ss.